2026/11/12
爬虫代理IP池怎么搭?自建、采购与混合方案全面对比
搭建代理IP池应先拆分任务,再设计资源层、调度层、监控层和故障切换层。自建、采购与混合方案可以接入同一套业务架构,差别主要在资源来源、维护责任和扩容方式。
搭建代理IP池应先拆分任务,再设计资源层、调度层、监控层和故障切换层。自建、采购与混合方案可以接入同一套业务架构,差别主要在资源来源、维护责任和扩容方式。
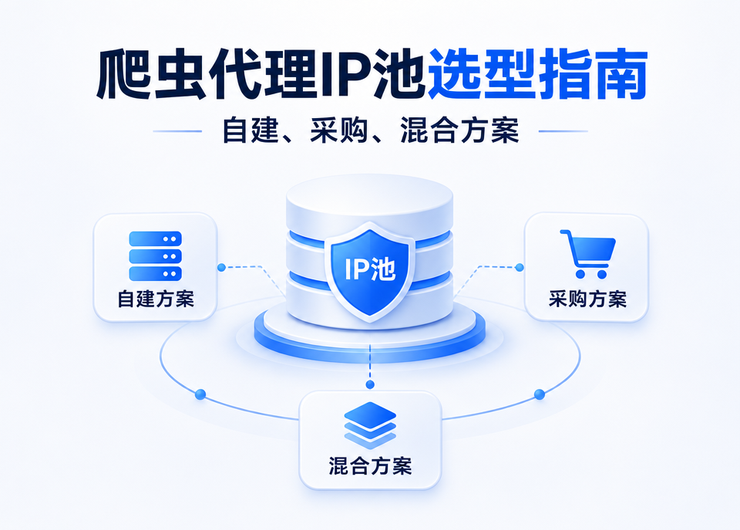
代理IP池选型应先确定任务地区、请求方式、IP周期、调用量和维护能力,再比较自建、采购与混合方案。小规模验证优先采购,长期稳定任务评估自建,多任务和波动流量则使用混合方案。
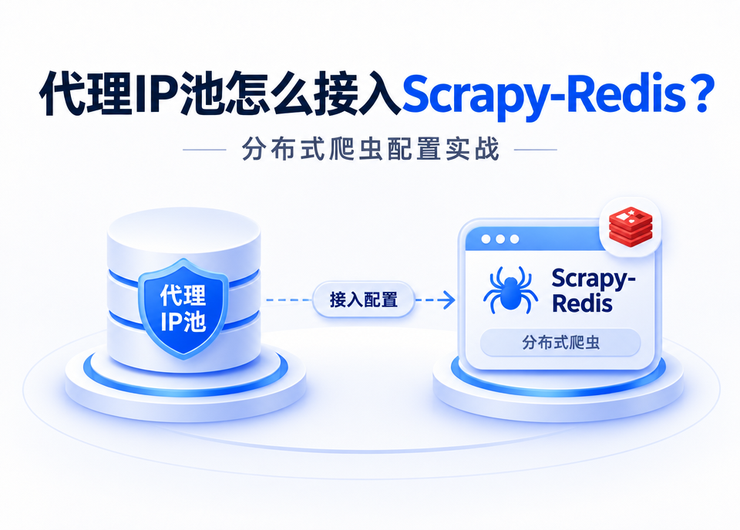
Scrapy-Redis负责共享任务队列和请求去重,代理IP池则负责代理领取、回收、失败冷却和状态统计。接入时应从`settings.py`、Redis键设计、下载器中间件、失败重试和多节点验证五个层面配置,避免把代理地址硬编码在单个爬虫节点中。
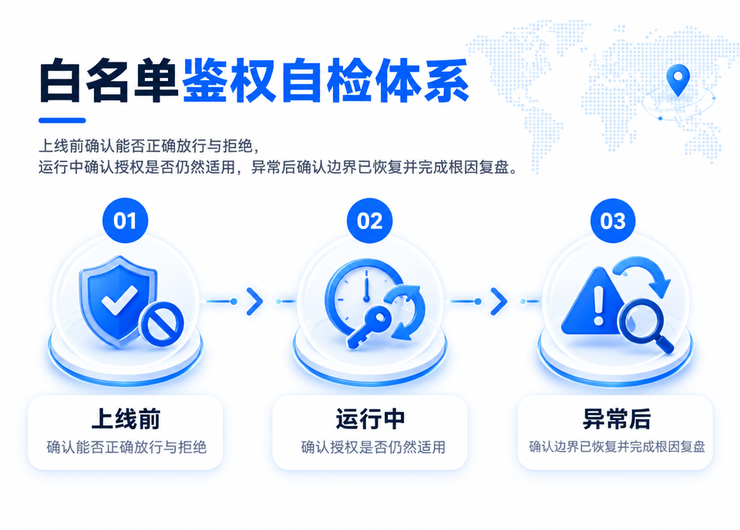
白名单鉴权自检体系应由四层组成:权限对象、配置状态、访问证据和处置闭环。上线前确认能否正确放行与拒绝,运行中确认授权是否仍然适用,异常后确认边界已恢复并完成根因复盘。
Scrapy代理IP选型应按访问频率、任务稳定性和成本结构逐项判断。低频、短时任务优先看提取灵活性;持续请求更关注隧道接入、异常切换和并发承载;长期任务则要比较固定出口、IP周期和企业服务,而不是只比较套餐价格。
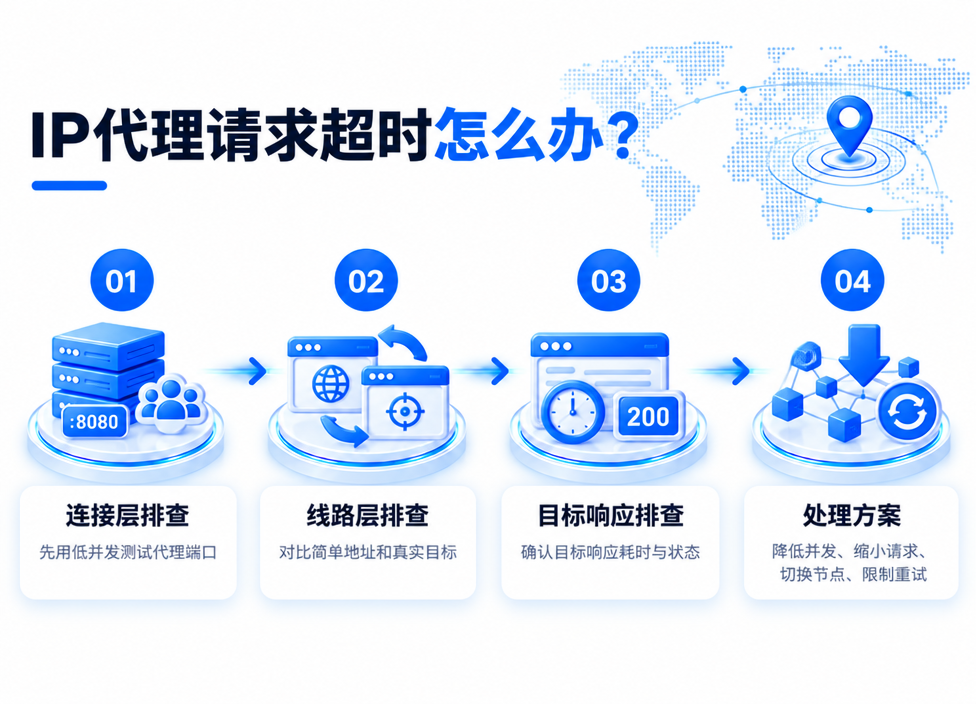
IP代理请求超时,建议按连接、线路、目标响应和并发四个层次排查。先用低并发测试代理端口,再对比简单地址和真实目标,最后通过降低并发、缩小请求、切换节点和限制重试处理。
HTTP代理连接失败,通常与代理地址、端口、协议、鉴权、网络链路或并发配置有关。排查时应先用单个代理和最小请求确认连通性,再根据错误类型定位问题,最后验证请求参数、并发和重试策略。
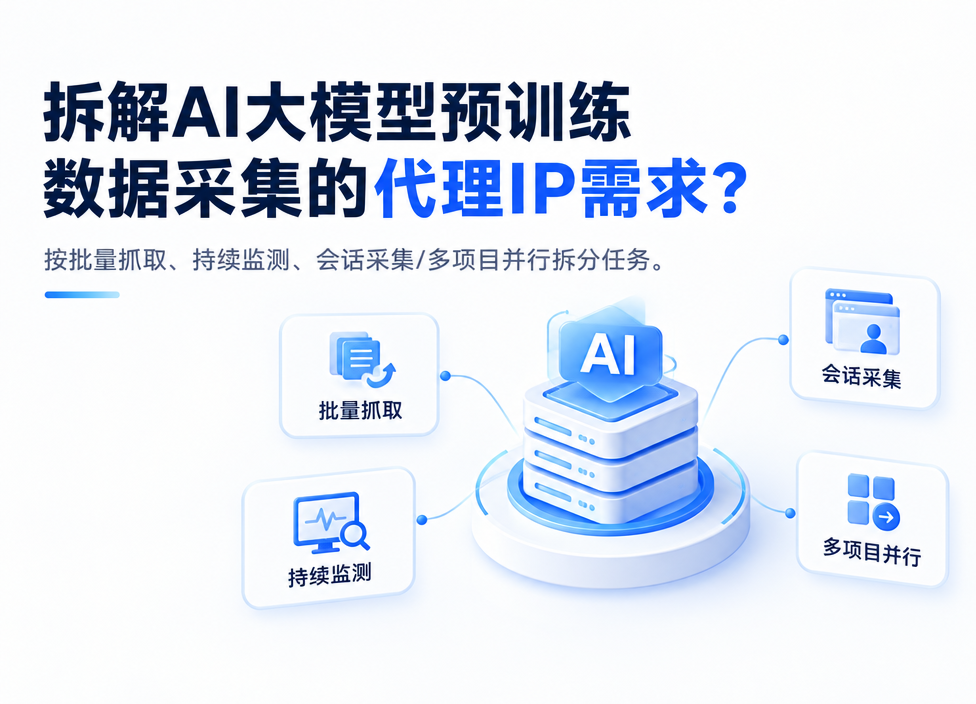
AI大模型预训练数据采集应先按批量抓取、持续监测、会话采集和多项目并行拆分任务,再匹配短效、隧道、长效或独享代理,最后核对稳定性、计费和合规边界。
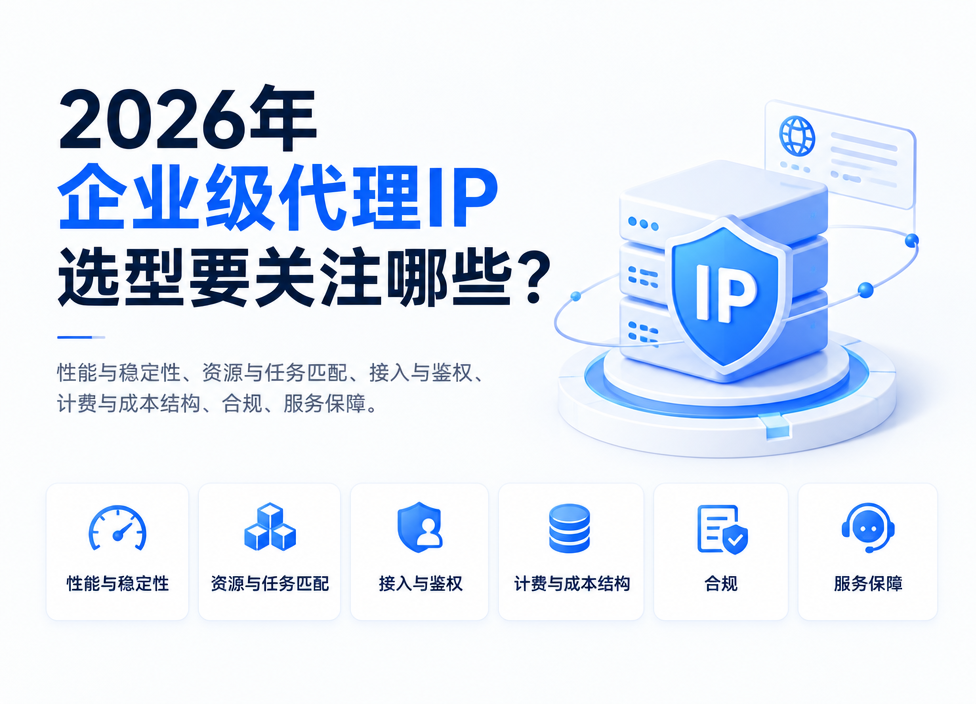
企业级代理IP选型通常涉及五个技术维度:性能与稳定性、资源与任务匹配、接入与鉴权、计费与成本结构、合规与服务保障。只有把五个维度放到同一评估框架中,才能减少选型偏差。
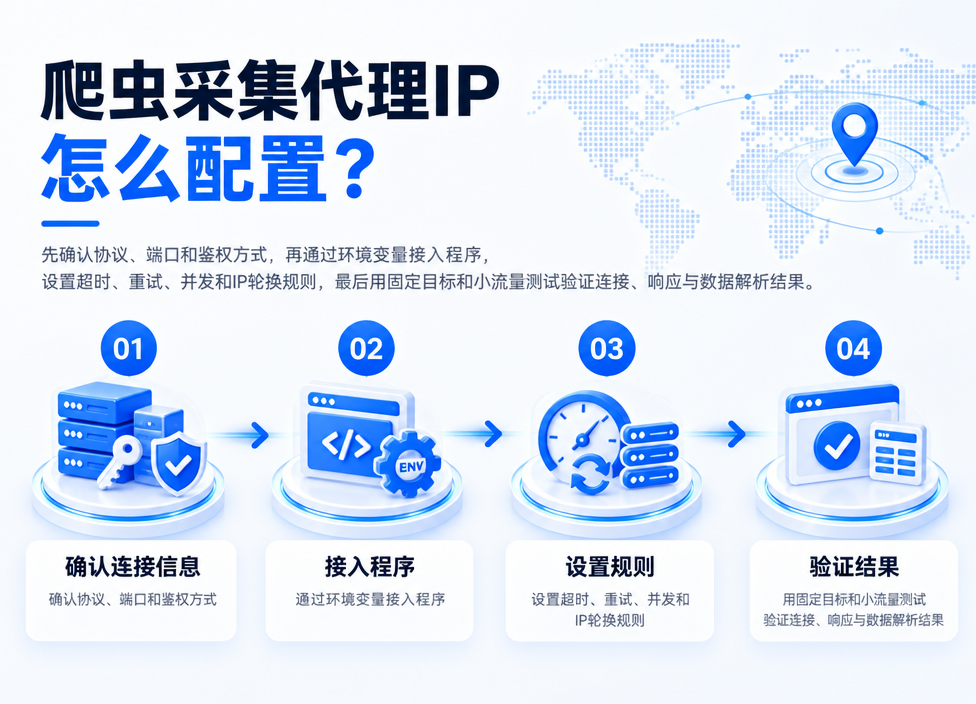
配置代理IP时,先确认协议、端口和鉴权方式,再通过环境变量接入程序,设置超时、重试、并发和IP轮换规则,最后用固定目标和小流量测试验证连接、响应与数据解析结果。
Python爬虫选择代理IP,不能只看资源池规模。文章从稳定性、节点覆盖、带宽和服务能力四个维度,对比极安代理、青果网络、快代理、站大爷与巨量代理,帮助开发者按任务周期和请求模型筛选服务商。
舆情监控代理IP不能只看响应速度,还要同时比较线路覆盖、IP切换、协议接入和技术支持。持续监控优先关注隧道代理与业务分池,区域监控重点看节点覆盖,大量短效轮换则要核对IP周期和提取规则。